盤點資料,再決定 AI 怎麼用
AI 時代的系統導入 2|企業資料真的可以上傳 AI 嗎?雲端、地端與去識別化
2026 Aug 23 AI 轉型應用
「我們公司不准把資料上傳 AI,那是不是什麼都不能做?」
「我把工具裝在自己的電腦裡,這樣應該就算地端了吧?」
「客戶姓名刪掉了,其他資料是不是就能放心交給 AI?」
這幾個問題,我認為比先選哪一套 AI 工具更值得企業主管討論。
上一篇,我們談到企業不必把每個營運問題都直接翻譯成「買系統」。但真的開始動手做,另一個問題很快就會出現:我們手上的資料,到底哪些能用、哪些不能上雲端?
我發現大家很容易把三件事混在一起:工具裝在哪裡、資料送去哪裡,以及資料本身到底有多機敏。這三件事如果沒有釐清,就算公司買了企業版 AI,或要求員工只能用本機工具,也不代表資料安全問題已經解決。
一、裝在自己的電腦,不代表資料就沒有離開電腦
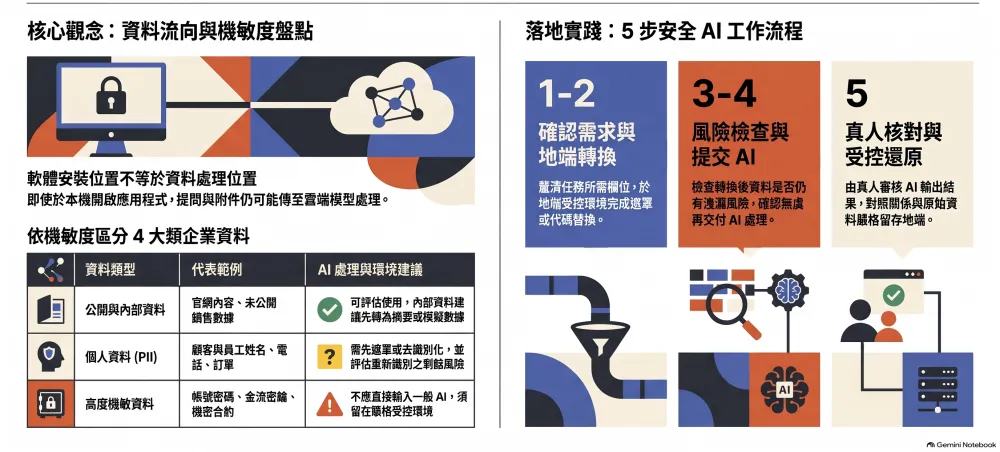
先說一個容易混淆的觀念:雲端與地端,真正需要確認的是資料在哪裡被處理、儲存,以及誰能取得,而不只是軟體從哪裡打開。
同仁可能是在自己的電腦上開啟應用程式,但提問內容與上傳文件仍然送往雲端模型處理。反過來說,企業也可能使用雲端服務,卻有經過確認的企業權限、契約與資料保護措施。
所以,當主管問「這套工具安不安全」,我反而想先問:
1. 原始資料會離開哪個環境?
2. 提問、附件和處理結果會被保存在哪裡、保存多久?
3. 哪些人或系統有權限接觸它?
4. 供應商的資料使用條款與企業設定,我們真的確認過了嗎?
不能只憑「地端」「私有部署」或「企業版」這幾個名稱,就直接判定安全。
二、先認識自己手上的資料,才知道要交給誰
我會建議企業先不要從全面禁止開始,而是挑一項想用 AI 改善的工作,盤點它實際會接觸哪些資料。
| 資料類型 | 日常例子 | AI 使用前先問什麼 |
|---|---|---|
| 公開資訊 | 已公開的商品介紹、官網資訊、公開新聞 | 來源是否正確?是否包含授權或著作權限制? |
| 內部營運資料 | 尚未公開的銷售數字、價格策略、內部會議紀錄 | 公司是否允許交由該工具處理?能否先用摘要或模擬資料? |
| 個人資料 | 顧客姓名、電話、地址、訂單與員工資料 | 這項任務真的需要可識別個人的內容嗎?有無合法使用依據及必要的安全措施? |
| 高度機敏資料 | 帳密、金流與帳戶資訊、未公開合約、薪酬或其他受限制資料 | 是否根本不應進入一般 AI 工具?是否需留在受控環境由授權人員處理? |
這張表只是讓大家開始盤點,不是所有企業通用的法規分級。真正能不能使用,仍要依公司政策、合約、資料用途與適用法規判斷。尤其有些資料單看一個欄位不敏感,和其他資料放在一起,就可能暴露客戶或企業的營運情況。
三、資料不能直接上傳,難道就不能用 AI 了?
也不是。我認為這正是企業值得學習的另一種 AI 能力:先處理資料,再決定如何讓 AI 協助。
舉例來說,主管想讓 AI 分析各區銷售表現,真的有必要讓 AI 知道每位顧客的姓名和電話嗎?不一定。要練習資料分析,也不見得要把公司的真實營收直接丟進工具裡。
我們可以依任務需求,採取不同的處理方法:
- 資料遮罩:將姓名、電話或其他不需要的欄位移除、隱藏,減少不必要的暴露。
- 去識別與代碼替換:以代碼取代識別資訊,必要時讓對照關係留在受控環境中。這種方式通常仍可能被重新識別,不能直接當成完全匿名。
- 模擬或比例轉換:如果目的是練習分析邏輯,可使用模擬資料或經核准的轉換資料;但必須確認轉換後是否仍可能洩漏商業秘密,也不能把練習結果當成真實營運數據。
我們正在實作的離線資料安全轉換工具,就是朝這個方向設計:先在地端進行去機敏與必要的數值轉換,再將經過檢查、適合該用途的資料交給 AI。工具的定位是降低不必要的資料暴露,不是按一個鍵就保證資料完全安全。結果需要還原時,原始資料及對照關係仍應留在適當的受控環境。
四、哪些放雲端、哪些留地端?先看任務,不要先看工具名稱
| 任務或資料 | 雲端 AI | 地端/受控環境 | 我的判斷 |
|---|---|---|---|
| 公開內容整理、一般提問 | 可評估 | 也可使用 | 先確認著作權、輸出品質與工具條款 |
| 經核准的去機敏資料分析 | 依殘餘風險評估 | 原始資料處理可先留地端 | 轉換前後都要檢查是否仍能識別個人或推知機密 |
| 客戶與員工個資 | 僅限經批准的環境與用途 | 視業務與存取權限安排 | 去掉姓名不代表已符合所有要求 |
| 帳密、金流密鑰、受限制的機密資料 | 不應直接輸入一般 AI 工具 | 留在具適當管控的授權環境 | 先處理權限與必要性,不是先想辦法上傳 |
上表談的是思考方向,並非「雲端一定不安全,地端一定安全」。本機工具仍可能連網,地端也有帳號權限、設備遺失及維護風險;使用企業雲端服務,同樣需要確認服務條款、管理設定與資料流向。
五、上完課能不能真的使用?我希望企業帶走的是一個安全的工作習慣
假設部門想讓 AI 協助整理營運報表。與其最後只留下「我們公司不能上傳資料」這一句話,不如讓同仁在課堂上真的走完一次:
確認任務需要什麼資料 → 判斷哪些欄位不能直接使用 → 在受控環境完成必要轉換 → 檢查能否交給指定 AI 工具 → 由真人核對輸出,並在授權環境使用結果。
有些資料判斷後就是不能上傳,那就不要勉強;可以改用模擬資料練習,或評估符合組織要求的處理環境。
我相信,AI 時代的工作能力不只是會下指令、會自動化,而是知道自己正在交出什麼資料,知道什麼情況應該停止,仍然能找到適合的方式,把工作往下推進。
這才是企業真正需要培養的 AI 使用習慣。
常見提問|企業資料與 AI 安全使用
Q1|工具裝在自己的電腦裡,資料就一定不會上雲端嗎?
不一定。我會先問:資料在哪裡被處理和儲存?提問與附件有沒有送往外部模型?是本機操作介面,還是真正在本機完成運算?只看安裝位置,不能判斷資料流向。
Q2|企業一律禁止上傳資料,是不是比較安全?
我認為應該先釐清資料類型和使用目的。有些資料確實不該交給一般 AI 工具,但有些任務可改用公開資訊、模擬資料,或在核准的環境先完成必要轉換。重點不是勉強上傳,而是知道有哪些適當的工作方式。
Q3|把客戶姓名和電話刪掉,就算完成去識別化嗎?
不一定。訂單時間、地址、稀有交易特徵等資料組合起來,仍可能識別特定個人。資料遮罩、代碼替換和真正匿名化不是同一件事;是否能使用,還得看剩餘風險、公司政策與實際用途。
Q4|使用離線資料轉換工具,就能保證資料安全嗎?
離線轉換可以協助減少原始資料暴露,但轉換後仍可能保留可推知的資訊。原始檔與對照表也要留在受控環境,確認資料用途與工具條款,並由真人核對結果;不能把工具當成安全保證。
參考依據|為什麼不能把資料遮罩當成安全保證?
上述判斷可對照以下公開技術與風險管理資料。這些資料提供原則,並非對本文提到的工具進行測試或認證。
- NIST SP 800-188|去識別技術與治理:說明移除識別欄位、處理間接識別資訊及評估重新識別風險;僅遮蔽個資,不代表完成充分的去識別。
- NIST IR 8053|個人資訊去識別:說明去識別可降低風險,但部分經過處理的資料仍可能被重新識別。
- NIST AI Risk Management Framework:提供組織辨識、評估及管理 AI 風險的架構,可作為企業檢查資料與工具用途時的參考。
作者|李其縵 Mandy
企業 AI 應用與敏捷營運講師/顧問,長期參與企業 AI 導入、主管培訓與工作流程改善。本文整理企業實務決策與技術資料,並非資安產品認證報告。
LinkedIn|李其縵 Mandy
本篇為企業實務觀察與工具應用討論,不取代個別法規、資訊安全或契約合規審查。文中提到的離線轉換工具為實作方向,並非已取得特定資安驗證或合規認證之聲明。
相關文章


跟著薩提爾模式與陳茂雄老師練習自我覺察_如何透過冰山表格與我訊息來做情緒管理
這個部份協助你透過正確情緒認知,並檢驗情緒盲點,找出你的不同情緒是否可運作與健康的展現,透過冰山圖及我訊息來進行情緒管理的四步驟 面對、接受、處理、放下過程,讓情緒模式越來越健康並趨近一致性,希望大家一起透過薩提爾模式跟陳茂雄教練的書中帶領,可以完整的做你自己。
- 2021 Jul 12


員工績效提升關鍵!不同員工狀態到個人化OJT(工作指導)設計 |周育如
OJT工作指導看似簡單,其實要設計好要考慮到很多方方面面,企業一般的OJT是學習跟工作相關任務的標準作業流程,但是OJT就是主管在日常指導員工的培訓方法,透過溝通、說明、員工實際操作、帶領操作等等來提昇員工在對應職務上所需要的工作能力.
- 2022 Sep 13
2027企業內訓課程推薦:HR年度教育訓練規劃的熱門主題、講師與選課指南
2027年度教育訓練,不要只從熱門課程開始。本文從主管管理、AI工作應用、員工體驗與跨部門協作、高價值顧客與服務四大趨勢,整理企業內訓課程、講師選擇與HR培訓規劃方法。
- 2026 Aug 31

跟著薩提爾模式與陳茂雄老師練習自我覺察
這本書很推薦想要更了解自己、想知道薩提爾模式如何運用的、想做好情緒管理、想探索內在思考或想改變的人閱讀,人生中很多起起伏伏,了解自己並找出適合自己的工作、生活、關係模式才能讓你的人生幸福愉快。
- 2021 Jul 10
如想留言評分,請先 登入會員!